Recenzja Seedance 2.0: funkcje, prompty i alternatywy w 2026
Seedance 2.0 pojawiła się na początku lutego 2026 roku i w ciągu 48 godzin zdominowała X i Reddita. Twórcy publikowali klipy, które wyglądały, jakby powstały w profesjonalnym studiu produkcyjnym, a nie w modelu AI. Benchmarki potwierdziły ten szum: ELO 1269 w text-to-video i 1351 w image-to-video, co w momencie premiery dawało jej przewagę nad Kling 3.0, Veo 3 i Runway Gen-4.5.
Dwa miesiące później opadł kurz. Spędziliśmy tygodnie, testując Seedance 2.0 w różnych scenariuszach — sceny kinowe, reklamy produktów, portrety, sekwencje fantasy — i przeczytaliśmy setki postów społeczności, żeby oddzielić to, co naprawdę działa, od tego, co dobrze wygląda tylko na demie. Ta recenzja obejmuje mocne strony modelu, jego słabości, opinie prawdziwych użytkowników, porównanie z poprzednikiem i konkurencją oraz sześć przypadków użycia z promptami, które możesz przetestować już teraz.
Najważniejsze wnioski:
- Seedance 2.0 przyjmuje do 12 mieszanych danych wejściowych (tekst, obrazy, wideo, audio) i generuje klipy o długości 4–15 sekund w rozdzielczości do 2K z natywnym dźwiękiem.
- Zachowanie kamery, spójność postaci oraz renderowanie dłoni/kończyn są zauważalnie lepsze niż w Seedance 1.0.
- Dostęp poza Chinami pozostaje problemem. Agresywna moderacja treści oraz stroma krzywa uczenia się dla przypadkowych użytkowników to częste skargi.
- Seedance 2.0 jest już dostępna na PixVerse, więc możesz ją przetestować obok PixVerse V6, Kling, Veo i innych modeli bez zmiany platformy.
- Kolejny model ByteDance, Seedance 2.5, pojawia się już na platformach partnerskich z obietnicami 30-sekundowych klipów i 50 wejść referencyjnych — sprawdź nasz przewodnik po Seedance 2.5, aby dowiedzieć się, co zostało potwierdzone, a co jeszcze nie.
Czym jest Seedance 2.0?
Seedance 2.0 to multimodalny model wideo AI stworzony przez ByteDance. Został wydany 7 lutego 2026 roku jako całkowita przebudowa od podstaw — a nie stopniowa aktualizacja Seedance 1.0.
Poprzednia wersja przetwarzała tekst i obrazy za pomocą oddzielnych potoków. Seedance 2.0 zastępuje to zunifikowanym multimodalnym transformerem dyfuzyjnym, który koduje tekst, obraz, dźwięk i wideo we wspólnej przestrzeni reprezentacji. W praktyce oznacza to, że model może przyjąć prompt tekstowy, zdjęcie referencyjne twojej postaci, klip wideo pokazujący pożądany ruch kamery i ścieżkę audio — a następnie połączyć to wszystko w jeden wynik.
Model obsługuje do 12 zasobów referencyjnych na jedną generację: 9 obrazów, 3 filmy i 3 pliki audio. Oznaczasz je w prompcie za pomocą składni @ (@image1, @video1 itd.), aby dokładnie powiedzieć modelowi, gdzie każda referencja powinna zostać zastosowana.
Specyfikacje wyjściowe: 4–15 sekund wideo w rozdzielczości do 2K, z natywnym dźwiękiem stereo generowanym w tym samym przebiegu co obraz.
Mocne strony Seedance 2.0: co robi dobrze
Wejście multimodalne i system referencji @
System referencji to główna funkcja. Zamiast opisywać wszystko tekstem i mieć nadzieję, że model poprawnie to zinterpretuje, możesz pokazać mu, czego chcesz. Prześlij zdjęcie twarzy i oznacz je jako @image1 w prompcie, dodaj klip wideo pokazujący pożądaną trajektorię kamery i dołącz ścieżkę muzyki w tle. Model odczytuje każdą referencję i stosuje ją tam, gdzie określiłeś.
Działa to szczególnie dobrze w utrzymywaniu spójności postaci między wieloma generacjami. Prześlij tę samą referencję twarzy, a postać zachowuje swój wygląd — coś, co w większości konkurencyjnych modeli nadal wymaga obejść.
Kinowe zachowanie kamery
Seedance 2.0 obsługuje ruch kamery bardziej naturalnie niż większość testowanych przez nas modeli. Ujęcia śledzące, najazdy i powolne orbity wydają się płynne i celowe, a nie losowe. Jeden użytkownik Reddita zgłosił odtworzenie ruchów kamery z serialu Severance z „zaskakująco dokładnymi” wynikami.
Model dobrze reaguje na precyzyjny język kamery w promptach: „powolny dolly-in ze średniego ujęcia do zbliżenia” lub „ujęcie śledzące z niskiego kąta” dają przewidywalne rezultaty. Niejasne instrukcje, takie jak „kinowy”, dają mniejszą kontrolę, ale wynik i tak domyślnie wypada rozsądnie.
Jak kontrolować ruch kamery w Seedance 2.0:
- Używaj precyzyjnych terminów z zakresu kinematografii w prompcie. Zamiast „ruchoma kamera” napisz „powolny dolly-in z szerokiego ujęcia do średniego zbliżenia” lub „ujęcie śledzące z niskiego kąta, poruszające się od lewej do prawej”. Model rozpoznaje standardową terminologię filmową.
- Prześlij referencję @video pokazującą pożądany ruch. Nagraj przybliżony klip (nawet telefonem) pokazujący trajektorię, oznacz go jako
@video1i opisz w prompcie: „Kamera podąża trajektorią pokazaną w @video1”. - Używaj notacji osi czasu dla złożonych sekwencji. Napisz
0–4s: statyczne ujęcie ustanawiające→4–8s: powolny najazd do średniego ujęcia→8–12s: orbita wokół obiektu. Model generuje każdy segment jako część spójnego klipu.
W przeciwieństwie do Motion Brush w Runway Gen-4.5 (który umożliwia malowanie ruchu na poziomie regionu), Seedance 2.0 nie oferuje kontroli ruchu klatka po klatce. Zachowanie kamery jest kontrolowane wyłącznie przez język promptu i referencje wideo — mniej szczegółowo, ale szybciej w iteracji.
Natywna synchronizacja audio-wideo
Seedance 2.0 generuje dźwięk i wideo jednocześnie dzięki wspólnej dyfuzji. Obejmuje to:
- Dialogi z synchronizacją ust w ponad 7 językach
- Efekty dźwiękowe zsynchronizowane z akcjami na ekranie
- Otoczenie dźwiękowe i muzykę w tle pasującą do wizualnego nastroju
Jakość synchronizacji ust jest solidna w naszych testach — zauważalnie lepsza niż narzędzia do dubbingu w postprodukcji. Nie jest idealna, ale w większości przypadków eliminuje potrzebę oddzielnego potoku audio.
Spójność czasowa i realizm fizyczny
Postacie i obiekty zachowują swój kształt między klatkami z minimalnym migotaniem. Renderowanie dłoni — historycznie słabe ogniwo wideo AI — znacznie się poprawiło w porównaniu z wersją 1.0. Palce częściej zachowują prawidłową liczbę, a ruchy kończyn wyglądają na obciążone, a nie unoszące się.
Drapowanie tkanin, zachowanie wody i fizyka kolizji wydają się bardziej ugruntowane. Ma to znaczenie dla wszystkiego, co wykracza poza abstrakcyjne wizualizacje. Jeśli generujesz reklamę produktu lub narrację skoncentrowaną na postaci, wiarygodna fizyka decyduje o różnicy między „imponującym demo AI” a „użytecznym materiałem”.
Narracja wieloujęciowa
Możesz ustrukturyzować prompt jako oś czasu — 0–4s: szerokie ujęcie ustanawiające, 4–8s: średnie ujęcie śledzące itd. — a model generuje każdy segment jako spójną sekwencję. Postacie pozostają spójne, a przejścia między ujęciami są płynne, a nie gwałtowne.
To prawdziwa zmiana w przepływie pracy. Wcześniejsze modele wymagały generowania każdego ujęcia osobno i łączenia ich w postprodukcji. Seedance 2.0 obsługuje sekwencjonowanie natywnie.
Edycja wewnątrz wideo
Możesz zamienić postacie lub obiekty w istniejącym wideo bez regenerowania całego klipu. Chcesz zmienić strój swojej postaci? Zastąpić tło? Model modyfikuje docelowy element, zachowując resztę bez zmian. Nie jest to dostępne w większości konkurencyjnych modeli i oszczędza znaczną ilość czasu na iteracje.
Seedance 2.0 w skrócie
| Specyfikacja | Szczegóły |
|---|---|
| Deweloper | ByteDance |
| Data premiery | 7 lutego 2026 |
| Architektura | Zunifikowany multimodalny transformer dyfuzyjny |
| Dane wejściowe | Tekst + do 9 obrazów + 3 filmy + 3 pliki audio |
| Maksymalna rozdzielczość | 2K |
| Czas trwania | 4–15 sekund |
| Natywne audio | Tak (dialog, efekty, otoczenie, muzyka) |
| Języki synchronizacji ust | 7+ |
| Edycja wewnątrz wideo | Tak (zamiana postaci/obiektu) |
Gdzie Seedance 2.0 zawodzi
Żaden model nie trafia na rynek bez kompromisów. Oto te, które mają znaczenie.
Dostęp regionalny jest ograniczony. Seedance 2.0 została wprowadzona głównie przez chiński ekosystem ByteDance (aplikację Jimeng). Użytkownicy międzynarodowi napotykają opóźnienia w weryfikacji, blokady regionalne i problemy z płatnościami. Najprostszym obejściem jest dostęp przez PixVerse, który całkowicie usuwa bariery geograficzne.
Moderacja treści jest agresywna. Wielu użytkowników zgłasza oznaczanie promptów za nieszkodliwe treści. Generacje związane z twarzami są szczególnie podatne na wyzwalanie filtrów. Jeden komentarz na Reddicie podsumował to tak: „Cenzura po prostu zrujnowała Seedance 2.0”. To realne wąskie gardło dla komercyjnej pracy twórczej, gdzie potrzebny jest spójny wynik.
Krzywa uczenia się jest stroma. Jeśli chcesz po prostu wpisać zdanie i otrzymać wideo, Seedance 2.0 nie jest najłatwiejszym punktem wyjścia. System referencji @, prompty osi czasu i wejścia multimodalne są potężne — ale wymagają czasu na naukę. Recenzenci konsekwentnie oceniają ją wysoko dla profesjonalistów (8,5/10) i nisko dla przypadkowych użytkowników (5/10).
API jest wciąż w becie. Zespoły korporacyjne potrzebujące stabilnego dostępu programowego powinny przygotować się na przełomowe zmiany i niespodzianki związane z limitami zapytań.
Renderowanie tekstu w wideo jest niepewne. Jeśli twoja scena zawiera tekst na ekranie — szyld, planszę tytułową, etykietę produktu — spodziewaj się niespójnych wyników. To wspólna słabość większości modeli wideo w 2026 roku, ale warto o niej wspomnieć.
Brak wsparcia dla LoRA. Nie możesz dostroić modelu na własnych zbiorach danych. Jeśli potrzebujesz konkretnego stylu wizualnego lub wyglądu marki, którego model bazowy nie obejmuje, jesteś ograniczony do inżynierii promptów i obrazów referencyjnych.
Maksymalnie 15 sekund na klip. Wystarczająco długo na treści społecznościowe i reklamy, ale za krótko na pracę narracyjną. Prompting wieloujęciowy pomaga, ale nadal jesteś ograniczony do 15 sekund łącznie na generację.
Warunki licencji komercyjnej są niejasne. ByteDance nie opublikowało wyraźnych praw do komercyjnego wykorzystania wyników Seedance 2.0. Warunki usługi Jimeng przyznają prawa do korzystania z treści generowanych za pośrednictwem platformy, ale szczegóły dotyczące redystrybucji, dzieł pochodnych i odpowiedzialności w reklamie komercyjnej nie są wyraźnie omówione. Jeśli generujesz przez PixVerse, do wyniku zastosowanie ma licencja komercyjna PixVerse. W przypadku prac komercyjnych wysokiego ryzyka — reklam produktów, materiałów dla klientów, transmisji — potwierdź prawa przed publikacją.
Jak naprawić typowe błędy Seedance 2.0
Jeśli napotykasz problemy, nie jesteś sam. Oto najczęściej zgłaszane problemy i ich rozwiązania, oparte na raportach społeczności i naszych własnych testach.
| Problem | Prawdopodobna przyczyna | Rozwiązanie |
|---|---|---|
| Prompt oznaczony/odrzucony przez moderację | Słowa kluczowe związane z twarzą lub niejednoznaczne sformułowania wyzwalające filtry treści | Usuń jednoznaczne opisy twarzy. Używaj referencji @image zamiast opisywać twarze w tekście. Unikaj słów takich jak „realistyczny portret” w połączeniu z konkretnymi nazwiskami. |
| Czarne klatki lub niepowodzenie generacji | Prompt zbyt złożony dla wybranego czasu trwania/rozdzielczości | Ogranicz do jednej akcji na każde 4–5 sekund. Obniż rozdzielczość z 2K do 720p. Podziel prompty wieloujęciowe na krótsze segmenty. |
| Twarz postaci zmienia się między ujęciami | Brak spójnego punktu odniesienia | Prześlij to samo zdjęcie twarzy jako @image1 w każdej generacji. Odnieś się do niego jednoznacznie: „Osoba na @image1 idzie w stronę kamery”. |
| Dźwięk jest niezsynchronizowany z obrazem | Niedopasowanie wspólnej dyfuzji w złożonych scenach z synchronizacją ust | Wygeneruj ponownie z wyłączonym dźwiękiem, a następnie dodaj dźwięk w osobnym przebiegu. Ewentualnie uprość dialog do krótszych fraz. |
| Błąd „region nieobsługiwany” lub płatności | Jimeng wymaga chińskiej weryfikacji | Zamiast tego uzyskaj dostęp do Seedance 2.0 przez PixVerse — bez blokady regionalnej, bez potrzeby chińskiego numeru telefonu. |
| Zniekształcone dłonie/palce | Złożone interakcje dłoni bez prowadzenia referencyjnego | Dodaj obraz referencyjny pokazujący pożądaną pozycję dłoni. Unikaj promptów wymagających więcej niż jednej jednoczesnej interakcji dłoni. |
| Wynik wygląda „wygenerowany przez AI” lub plastikowo | Nadmierne poleganie na słowach kluczowych stylu bez podstaw fizycznych | Dodaj szczegóły fizyczne: konkretne materiały, rzeczywiste warunki oświetlenia, typ obiektywu. Użyj „nakręcone na Arri Alexa, 35mm” zamiast ogólnego „kinowy”. |
Jeśli twoja generacja konsekwentnie zawodzi po 3 lub więcej próbach z tą samą strukturą promptu, problem prawdopodobnie leży w złożoności promptu, a nie w błędzie platformy. Uprość, wygeneruj, a następnie stopniowo dodawaj złożoność z powrotem.
Ile kosztuje Seedance 2.0?
Seedance 2.0 jest darmowa na Jimeng z ograniczoną liczbą dziennych generacji i kosztuje 150 kredytów za 5-sekundowy klip (720p Standard) na PixVerse. Oto pełne zestawienie cen dla obu metod dostępu.
Na Jimeng (natywnej platformie ByteDance):
| Plan | Cena miesięczna | Dzienne generacje | Uwagi |
|---|---|---|---|
| Darmowy | 0 $ | ~5–10 klipów/dzień | Zablokowany do Chin, wymaga chińskiego telefonu |
| Basic | ~9,99 $ | 50+ klipów/dzień | Dostęp do wyższej rozdzielczości |
| Pro | ~29,99 $ | 200+ klipów/dzień | Priorytetowa kolejka |
| Premium | ~49,99 $ | Bez limitu | Wszystkie funkcje, najszybsza generacja |
Na PixVerse (globalny dostęp, bez blokady regionalnej):
| Poziom | 480p | 720p | 1080p |
|---|---|---|---|
| Standard | 15 kredytów/s | 30 kredytów/s | Dostępne |
| Fast | 10 kredytów/s | 20 kredytów/s | Niedostępne |
5-sekundowy klip w 720p Standard kosztuje 150 kredytów. Tryb Fast kosztuje 100 kredytów za ten sam klip. Członkowie Pro (9,99 $/mies.), Premium (24,99 $/mies.) i Ultra (49,99 $/mies.) mają dostęp do Seedance 2.0. Członkowie Ultra otrzymują 40% zniżki na kredyty przy wszystkich generacjach.
Porównanie kosztów za 5-sekundowy klip w 720p:
| Model | Platforma | Przybliżony koszt |
|---|---|---|
| Seedance 2.0 Standard | PixVerse | ~0,75 $ (150 kredytów) |
| Seedance 2.0 Fast | PixVerse | ~0,50 $ (100 kredytów) |
| PixVerse V6 | PixVerse | ~0,35 $ (70 kredytów) |
| Kling 3.0 | Kling | Wliczone w plan 10 $/mies. |
| Hailuo AI | MiniMax | Wliczone w plan 9,99 $/mies. |
| Sora 2 | OpenAI | ~0,50–2,50 $ |
Przy około 0,15 $ za sekundę (Standard 720p), Seedance 2.0 kosztuje za klip mniej więcej dwa razy więcej niż PixVerse V6, ale obejmuje wejście multimodalne — co czyni ją najbardziej opłacalną dla projektów, które w innym przypadku wymagałyby wielokrotnego dopasowywania referencji lub rozbudowanej postprodukcji.
Co mówi społeczność
Opinie twórców i profesjonalistów
Profesjonalni twórcy — filmowcy, producenci teledysków, agencje reklamowe — to najbardziej entuzjastyczna grupa użytkowników. System referencji multimodalnych i prompty osi czasu odpowiadają sposobowi, w jaki już myślą o produkcji: w kategoriach ujęć, referencji i sekwencji, a nie opisów tekstowych.
Jedna recenzja oceniła Seedance 2.0 na 8,5/10 dla profesjonalistów kreatywnych potrzebujących szczegółowej kontroli. Wczesny tester na X zauważył: „Mój współzałożyciel spędził cały dzień, próbując uzyskać ten efekt. Seedance 2.0 zrobiła to w 5 minut”.
Model jest opisywany jako coś, co „myśli jak reżyser” — reaguje na wskazówki na poziomie ujęcia, zamiast po prostu generować coś, co niejasno pasuje do twojego promptu. Dla zespołów już pracujących w przepływach preprodukcji jest to znacząca zmiana.
Reakcje w mediach społecznościowych i na forach
Społeczności na Reddicie (r/SeedanceAI_Lab, r/Seedance_v2) są aktywne i rosną. Najczęściej udostępniane wyniki to zazwyczaj kinowe klipy, które wyglądają bardziej jak materiał z aktorami niż typowe wideo AI.
Powszechne skargi w mediach społecznościowych pokrywają się z naszymi własnymi ustaleniami: trudność dostępu poza Chinami, fałszywe alarmy moderacji oraz czas potrzebny na naukę systemu promptów. Kilka wątków porównuje to do „posiadania potężnego aparatu, ale konieczności nauczenia się trybu ręcznego, zanim zaczniesz robić dobre ujęcia”.
Kontrowersje wokół praw autorskich
W ciągu kilku dni od premiery Disney wysłał do ByteDance list z żądaniem zaprzestania, twierdząc, że Seedance 2.0 generuje postacie Disneya na podstawie swoich danych treningowych. Motion Picture Association i SAG-AFTRA wydały publiczne oświadczenia. Wirusowe filmy z podobiznami celebrytów generowanymi przez AI dolały oliwy do ognia.
Jest to trwająca kwestia prawna w całej przestrzeni wideo AI, nie specyficzna dla Seedance 2.0. Ale warto to śledzić, jeśli planujesz używać modelu do pracy komercyjnej z rozpoznawalnymi postaciami lub podobiznami.
Seedance 2.0 kontra Seedance 1.0: co się zmieniło
Skok z 1.0 do 2.0 to pełna przebudowa architektoniczna. Oto jak się porównują:
| Funkcja | Seedance 1.0 | Seedance 2.0 |
|---|---|---|
| Architektura | Oddzielne potoki tekstu i obrazu | Zunifikowany multimodalny transformer dyfuzyjny |
| Wejście tekstowe | Tak | Tak |
| Wejście obrazu | Jeden opcjonalny obraz | Do 9 obrazów z kontrolą tagów @ |
| Wejście wideo | Nie | Do 3 filmów referencyjnych |
| Wejście audio | Nie | Do 3 plików audio |
| Natywne wyjście audio | Nie | Tak (dialog, efekty, otoczenie, muzyka) |
| Maksymalna rozdzielczość | 1080p | 2K |
| Czas trwania | 5–10 sekund | 4–15 sekund |
| Wiele ujęć | Podstawowe | Storyboard osi czasu ze spójnością między ujęciami |
| Jakość dłoni/kończyn | Częste artefakty | Zauważalnie poprawiona |
| Edycja wewnątrz wideo | Nie | Tak (zamiana postaci/obiektu) |
| Wskaźnik użytecznych wyników | ~60% | 90%+ przy pierwszej próbie |
Dwie największe aktualizacje w codziennym użytkowaniu to natywne audio (1.0 nie miała żadnego) i system referencji multimodalnych (1.0 był ograniczony do jednego opcjonalnego obrazu). Jeśli wypróbowałeś 1.0 i zrezygnowałeś, 2.0 to fundamentalnie inne narzędzie.
A co z Seedance 2.5?
ByteDance nie próżnuje. Nowsza wersja — oznaczona jako Seedance 2.5 — pojawiła się już na publicznych stronach Dreamina/CapCut, z obietnicami 30-sekundowych standardowych klipów (w porównaniu z 15-sekundowym limitem 2.0), 180-sekundowym trybem beta dla długich filmów, do 50 wejść referencji multimodalnych oraz nowym systemem referencja-do-wideo (R2V) do kontrolowania ruchu postaci za pomocą materiału green-screen lub modelu białego. Nic z tego nie zostało jeszcze niezależnie zweryfikowane — to tekst dostawcy, a nie testy laboratoryjne — więc traktuj te specyfikacje jako orientacyjne, a nie potwierdzone. Jeśli te liczby się potwierdzą, 2.5 byłaby większym skokiem względem 2.0, niż 2.0 był względem 1.0. Dokładnie rozkładamy na czynniki pierwsze to, co zostało potwierdzone, a co pozostaje niezweryfikowane, w naszym przewodniku po Seedance 2.5. Dopóki 2.5 nie zostanie szeroko wprowadzona ze zweryfikowanymi wynikami, wszystko w tej recenzji nadal dotyczy dostępnego dziś modelu 2.0.
Przypadki użycia Seedance 2.0: sześć przetestowanych promptów
Przetestowaliśmy Seedance 2.0 w sześciu scenariuszach obejmujących najczęstsze potrzeby twórcze. Każdy poniższy prompt jest gotowy do skopiowania i przetestowania. Dla każdego opisujemy, co otrzymaliśmy, ile to trwało i co zadziałało lub nie.
Wszystkie testy przeprowadzono na PixVerse przy użyciu Seedance 2.0 Standard w 720p, 5–8 sekund, proporcje 16:9, chyba że zaznaczono inaczej.
Kinowa scena filmowa
Ten prompt testuje zachowanie kamery, atmosferę i renderowanie postaci w ciemnych, kontrastowych warunkach — rodzaj sceny, który szybko ujawnia artefakty ruchu.
Prompt:
A retired detective in a long dark coat walks through a rain-soaked alley at night. Neon signs reflect red and blue on the wet cobblestones. He pauses, lights a cigarette, and glances over his shoulder. Slow push-in from wide shot to medium close-up. Film noir style, anamorphic lens flare, teal-orange color grading, film grain.
Co otrzymaliśmy: Najazd kamery był płynny i stabilny — bez drgań czy nagłych skoków. Odbicia deszczu na mokrych kocich łbach wyglądały przekonująco, a neonowe kolory rozlewały się na mokrej powierzchni tak, jak powinny. Płaszcz detektywa poruszał się naturalnie podczas chodzenia, a gest zapalania papierosa został obsłużony bez żadnego zniekształcenia dłoni. Dźwięk otoczenia zawierał deszcz i odległy hałas miasta, co dobrze pasowało do sceny. Generacja zajęła około 70 sekund w trybie Standard. Ogólnie rzecz biorąc, jest to rodzaj wyniku, który mógłbyś umieścić w rolce nastrojowej lub prezentacji krótkometrażowego filmu bez większej pracy postprodukcyjnej.
Reklama produktu
Ujęcia produktowe to praktyczny test symulacji fizyki: czy światło uderza w powierzchnię poprawnie, czy obrót wydaje się mechanicznie płynny i czy materiał wygląda tak, jak powinien?
Prompt:
A luxury perfume bottle rotates slowly on a black marble surface. Golden liquid catches the light as it turns. Soft particles of gold dust float in the air around it. Macro close-up, slow 360-degree orbit camera. Studio lighting with warm rim light, high-end commercial photography style.
Co otrzymaliśmy: Refrakcja szkła i zachowanie płynu wewnątrz butelki były zaskakująco dokładne. Złote cząstki unosiły się w naturalnym tempie, a marmurowa powierzchnia miała widoczną teksturę ziarnistości. Kamera orbitująca była płynna przez cały obrót. Światło uderzało w szkło pod właściwymi kątami, tworząc rodzaj kaustycznych refleksów, jakich oczekiwałbyś od prawdziwego studia. Całkowity czas generacji: około 65 sekund. Jako pierwszy szkic koncepcyjnego wideo produktu oszczędza to godziny w porównaniu do przygotowania renderowania 3D.
Teledysk
Teledyski wymagają ekspresyjnego ruchu, dramatycznych zmian oświetlenia oraz zdolności do utrzymania wyglądu postaci podczas dynamicznego ruchu. To tutaj spójność czasowa jest poważnie testowana.
Prompt:
A female singer in a flowing red silk dress performs on a rooftop at sunset. City skyline stretches behind her. Wind blows her hair and dress dramatically. She sings with emotional intensity, arms spread wide. Dynamic tracking shot circling around her. Golden hour backlighting, lens flare, vibrant warm tones.
Co otrzymaliśmy: Fizyka sukni była najmocniejszym punktem — czerwony jedwab łapiący wiatr i światło w sposób, który wyglądał fizycznie, a nie proceduralnie. Orbita śledząca wokół piosenkarki była płynna, a jej twarz pozostawała spójna przez cały obrót. Ruch włosów wydawał się naturalny i pasował do kierunku wiatru na sukni, co jest szczegółem, który wiele modeli myli. Natywne audio wygenerowało ścieżkę muzyczną otoczenia pasującą do tempa jej ruchów. Generacja: około 75 sekund. Jeśli budujesz moodboard lub wideo koncepcyjne dla projektu muzycznego, to zbliża cię o 80% do celu w jednej generacji.
Portret postaci w ruchu
Subtelny ruch jest trudniejszy niż dramatyczna akcja dla większości modeli wideo. Małe gesty — obrót głowy, dłonie badające przedmiot — ujawniają niestabilność czasową, którą szybkie sceny mogą ukryć.
Prompt:
An elderly Japanese craftsman in a traditional wooden workshop, morning light streaming through paper screens. He slowly lifts a hand-forged ceramic tea bowl, examining it with quiet pride. His weathered hands rotate the bowl gently. Close-up of his hands, then slow tilt up to reveal his face. Wabi-sabi aesthetic, warm natural light, documentary portrait quality.
Co otrzymaliśmy: To był jeden z najsilniejszych wyników w naszych testach. Dłonie — zazwyczaj najsłabsze ogniwo w wideo AI — pozostały stabilne z prawidłową liczbą palców i naturalnym ruchem stawów przez cały klip. Przechylenie kamery z dłoni na twarz było płynne, a przejście ostrości wydawało się jak prawdziwe przełączenie ostrości obiektywu. Poranne światło przez papierowe przesłony rzucało miękkie, równomierne cienie. Model samodzielnie dodał subtelne dźwięki otoczenia warsztatu: odległego ptaka, delikatny brzęk ceramiki. Tekstura skóry na zniszczonych rękach wyglądała realistycznie bez nadmiernego wyostrzenia. Generacja: około 80 sekund. Dla treści w stylu dokumentalnym lub narracji marki, ten poziom subtelności to dokładnie to, czego potrzebujesz.
Natura i krajobraz
Ujęcia lotnicze i krajobrazowe testują spójność na dużą skalę: czy model może utrzymać spójne otoczenie przy poruszającej się kamerze przez kilka sekund?
Prompt:
Aerial drone shot gliding over a misty mountain valley at sunrise. Layers of fog roll between emerald green peaks. A winding river reflects the golden morning light below. Eagles soar through the frame at eye level. Smooth forward tracking with slight descent. Epic landscape, volumetric fog, golden hour lighting.
Co otrzymaliśmy: Warstwy mgły poruszały się niezależnie i z różnymi prędkościami, co nadawało scenie prawdziwą głębię zamiast wyglądu płaskiego matowego obrazu. Odbicie rzeki poprawnie aktualizowało się w miarę postępu kamery — szczegół, który wymaga od modelu świadomości przestrzennej. Ogólna paleta kolorów — ciepłe złoto uderzające w chłodne niebieskozielone góry — została dobrze obsłużona, a wolumetryczna mgła wydawała się trójwymiarowa. Dźwięk zawierał wiatr i odległe odgłosy ptaków pasujące do otoczenia. Była to również najszybsza generacja w naszej serii: około 55 sekund. Wynik jest zbliżony do tego, co uzyskałbyś z profesjonalnego nagrania dronem, minus budżet podróży.
Anime i fantasy
Stylizowane treści to inne wyzwanie niż fotorealizm. Model musi utrzymać spójny styl artystyczny (cieniowanie cel, linie prędkości, płaski kolor), jednocześnie generując wiarygodny ruch.
Prompt:
An anime warrior princess stands atop a cliff overlooking a burning medieval city at night. Her long silver hair and crimson cape billow in the wind. She draws a glowing blue katana, electricity crackling along the blade. Cherry blossom petals swirl around her. Dynamic low-angle shot with slow push-in. Cel-shading style, vibrant neon accents, dramatic speed lines.
Co otrzymaliśmy: Cieniowanie cel pozostało spójne przez cały klip — bez mieszania się stylu anime i fotorealistycznego, co jest częstym problemem w innych modelach. Dobycie katany było płynne, a efekt elektryczności wzdłuż ostrza wyglądał, jakby należał do prawdziwego anime, a nie do ogólnego nakładania blasku. Płatki kwiatów wiśni poruszały się niezależnie, a niektóre wychwytywały blask ognia płonącego miasta poniżej. Dźwięk zawierał dramatyczny świst miecza przy dobyciu, który idealnie pasował do ruchu. Generacja: około 70 sekund. Spójność stylu jest najtrudniejszą rzeczą do uzyskania w anime generowanym przez AI, a Seedance 2.0 poradziła sobie z tym lepiej niż większość testowanych przez nas modeli.
Alternatywy dla Seedance 2.0: jak najlepsze generatory wideo AI porównują się w 2026 roku
Seedance 2.0 to silny model, ale nie jedyna opcja — i w zależności od potrzeb może nie być najlepszym wyborem. Poniżej porównujemy Seedance 2.0 z PixVerse V6, Runway Gen-4.5, Pika 2.2, Luma Ray3 i pięcioma innymi wiodącymi modelami pod względem rozdzielczości, cen, dźwięku i dopasowania do przepływu pracy.
PixVerse V6 — oraz Seedance 2.0 na PixVerse
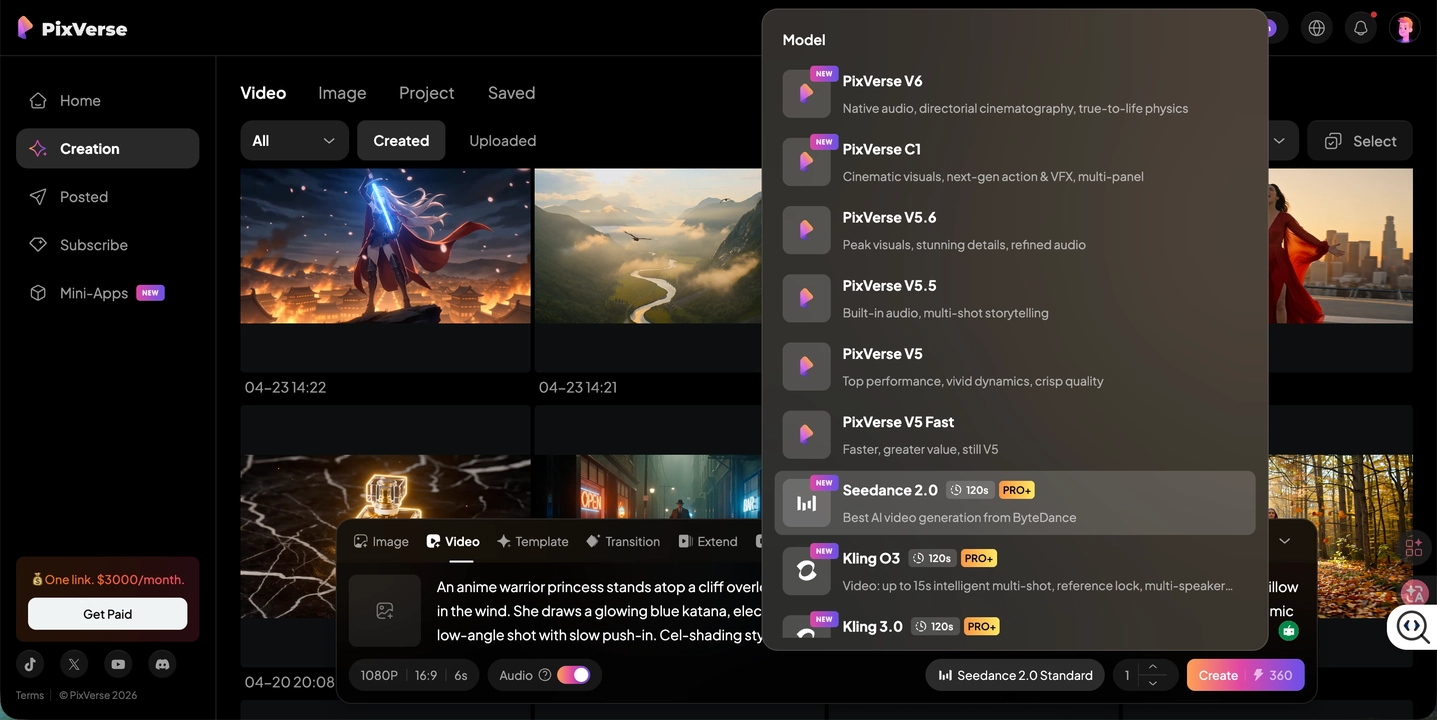
Zanim porównamy poszczególne modele, warto poruszyć praktyczny problem: każdy model żyje na własnej platformie z własnym kontem, cenami i przepływem pracy. Jeśli chcesz przetestować Seedance 2.0 przeciwko Kling 3.0 dla reklamy produktu, zwykle potrzebujesz dwóch kont i dwóch zestawów kredytów.
PixVerse to rozwiązuje. Seedance 2.0 zadebiutowała na PixVerse 13 kwietnia 2026 roku, dołączając do Kling O3, Veo 3.1, Sora 2 i innych modeli. Jedno konto, jedno saldo kredytów, porównanie bezpośrednie.
Seedance 2.0 na PixVerse występuje w dwóch poziomach:
| Poziom | 480p | 720p | 1080p |
|---|---|---|---|
| Standard | 15 kredytów/s | 30 kredytów/s | Dostępne |
| Fast | 10 kredytów/s | 20 kredytów/s | Niedostępne |
5-sekundowy klip w 720p Standard kosztuje 150 kredytów. Fast kosztuje 100 kredytów za ten sam klip. Członkowie Pro, Premium i Ultra mają dostęp do Seedance 2.0. Członkowie Ultra otrzymują 40% zniżki na kredyty przy wszystkich generacjach.
Poza hostowaniem modeli firm trzecich, PixVerse V6 to również silna alternatywa sama w sobie. Przyjmuje inne podejście — podczas gdy Seedance 2.0 wyróżnia się precyzją wielorefererencyjną, PixVerse V6 koncentruje się na kontroli kamery i produkcji wieloujęciowej.
| Funkcja | PixVerse V6 | Seedance 2.0 |
|---|---|---|
| Maksymalny czas trwania | 15 sekund | 15 sekund |
| Kontrola kamery | 20+ sparametryzowanych kontroli (dolly, żuraw, orbita, śledzenie) | Opis oparty na prompcie |
| Natywne audio | Tak | Tak (synchronizacja ust w 7+ językach) |
| Typy wejścia | Tekst + obraz; silnik wieloujęciowy | Tekst + 9 obrazów + 3 filmy + 3 pliki audio |
| Edycja wewnątrz wideo | Nie | Tak |
| Wiele ujęć | Film z jednego promptu z natywnym audio | Storyboard osi czasu |
| Dostęp | Web, mobile, API, CLI | Jimeng (Chiny) lub PixVerse |
| Koszt (1080p, za sekundę) | 14 kredytów (~0,07 $) | 30 kredytów Standard (~0,15 $) |
Wybierz V6, gdy: potrzebujesz precyzyjnych ruchów kamery, integracji CLI dla przepływów pracy deweloperów (działa z Claude Code, Codex, Cursor) lub globalnego dostępu bez ograniczeń.
Wybierz Seedance 2.0, gdy: potrzebujesz kontroli wejścia wielorefererencyjnego, wyjścia o wyższej rozdzielczości lub edycji wewnątrz wideo.
Oba są dostępne na PixVerse, więc nie musisz zobowiązywać się do jednego z nich.
Sora 2 (OpenAI)
Sora 2 jest najsilniejsza w narracji i symulacji fizyki. Przestrzeganie promptu jest wysokie, a model radzi sobie ze scenami emocjonalnymi — momentami napędzanymi dialogiem, subtelnymi interakcjami postaci — lepiej niż większość konkurentów. Wymaga subskrypcji ChatGPT Plus (20 $/mies.) lub Pro (200 $/mies.). Cennik API wynosi od 0,10 do 0,50 $ za sekundę w zależności od rozdzielczości. Maksymalne wyjście: 1080p, do 20 sekund.
Veo 3 (Google)
Veo 3 to mistrz rozdzielczości: natywne wyjście 4K z opcją 60 kl./s i dźwiękiem przestrzennym. Płynnie integruje się z przepływami pracy Google Cloud, co czyni go atrakcyjnym dla zespołów korporacyjnych już w tym ekosystemie. Kompromisem jest czas trwania — klipy są ograniczone do 8 sekund, co ogranicza jego przydatność dla treści narracyjnych. Ceny zaczynają się od 0,05 $/s dla poziomu Lite.
Kling 3.0 (Kuaishou)
Kling 3.0 oferuje najlepszy stosunek jakości do ceny za klip. Natywne 4K przy 60 kl./s, wielojęzyczna synchronizacja ust oraz Multi-Shot AI Director, który obsługuje do sześciu cięć kamery w jednej 15-sekundowej generacji. Element Binding utrzymuje spójność postaci i obiektów między ujęciami. Plany zaczynają się od 10 $/mies. Poziom darmowy istnieje, ale jest ograniczony do Kling 2.0.
Runway Gen-4.5
Runway ma najbardziej dojrzały zestaw narzędzi do edycji. Motion Brush daje kontrolę na poziomie klatek nad tym, jak poruszają się określone regiony twojego wideo. Jeśli już pracujesz w potoku postprodukcji z After Effects lub DaVinci Resolve, Runway pasuje naturalnie. Wada: maksymalna rozdzielczość 720p i limit klipu 10 sekund. Cennik API wynosi około 0,12 $ za sekundę.
Hailuo AI (MiniMax)
Hailuo to opcja szybkości. Czasy generacji wynoszą 30–90 sekund na klip — najszybsze w tym porównaniu. Zajmuje #1 miejsce w WorldModelBench pod względem symulacji fizyki i dobrze radzi sobie z anime i stylizowanymi treściami. Maksymalna rozdzielczość to 1080p, ale klipy są ograniczone do 10 sekund. Plany zaczynają się od 9,99 $/mies.
Pika 2.2 (Pika Labs)
Pika 2.2 koncentruje się na kreatywnej edycji, a nie na surowej generacji. Jej funkcja Scene-to-Scene pozwala przekształcić istniejący materiał w zupełnie nowe style wizualne, a Lip Sync obsługuje nakładanie dialogów bez konieczności pełnej regeneracji wideo. System Pikaffects stosuje stylizowane transformacje (zgniatanie, topienie, eksplozję), które są popularne w treściach społecznościowych. Przy 8 $/mies. za plan standardowy jest to jedna z najbardziej przystępnych cenowo opcji. Maksymalna rozdzielczość to 1080p z klipami do 10 sekund. Kompromis: surowa jakość generacji i symulacja fizyki Piki pozostają w tyle za Seedance 2.0, Kling i Veo w benchmarkach.
Luma Ray3 (Dream Machine)
Ray3 celuje w profesjonalną postprodukcję. Natywne 1080p z HDR, 16-bitowe wyjście klatek EXR do potoków korekcji kolorów oraz Draft Mode, który generuje 5x szybciej przy 5x niższym koszcie dla szybkiego prototypowania. Funkcja Modify Video rozszerza się do 18 sekund. Plany zaczynają się od 9,99 $/mies.
Szybkie porównanie trójstronne
Szukasz bezpośredniego porównania? Oto jak dzielą się najlepsze modele według głównej siły:
- Precyzja wielorefererencyjna + narracja kinowa: Seedance 2.0
- Kontrola ruchu na poziomie klatek + integracja z postprodukcją: Runway Gen-4.5
- Przepływy pracy HDR/EXR + szybkie prototypowanie: Luma Ray3
- Kreatywne efekty + treści społecznościowe na budżecie: Pika 2.2
- Sparametryzowana kontrola kamery + dostęp CLI/deweloperski: PixVerse V6
Pełna tabela porównawcza
| Model | Maks. czas trwania | Natywne audio | Cena początkowa | Najlepsze do |
|---|---|---|---|---|
| Seedance 2.0 | 15s | Tak | ~150 kredytów/klip na PixVerse | Kontrola wielorefererencyjna, narracje kinowe |
| PixVerse V6 | 15s | Tak | ~70 kredytów/klip | Kontrola kamery, filmy wieloujęciowe, przepływy CLI |
| Sora 2 | 20s | Nie | 0,10 $/s | Narracja, symulacja fizyki |
| Veo 3 | 8s | Tak (przestrzenne) | 0,05 $/s | Fotorealizm 4K, korporacje |
| Kling 3.0 | 15s | Tak | 10 $/mies. | Wartość, długa forma, wiele ujęć |
| Runway Gen-4.5 | 10s | Nie | ~0,12 $/s | Motion Brush, narzędzia dla filmowców |
| Pika 2.2 | 10s | Nie | 8 $/mies. | Kreatywne efekty, treści społecznościowe, budżet |
| Hailuo AI | 10s | Nie | 9,99 $/mies. | Szybkość, budżet, fizyka |
| Luma Ray3 | ~10,5s | Nie | 9,99 $/mies. | Przepływy HDR, postprodukcja |
Wypróbuj Seedance 2.0 na PixVerse
Najczęściej zadawane pytania
Czym jest Seedance 2.0?
Seedance 2.0 to multimodalny model wideo AI od ByteDance, wydany w lutym 2026 roku. Generuje klipy wideo o długości 4–15 sekund w rozdzielczości do 2K z natywnym dźwiękiem. Model przyjmuje tekst, obrazy, wideo i dźwięk jako połączone wejścia — do 12 zasobów referencyjnych na generację.
Czy Seedance 2.0 jest darmowa?
Seedance 2.0 oferuje darmowe i płatne poziomy na swojej natywnej platformie (do 49,99 $/mies.). Na PixVerse jest dostępna dla członków Pro, Premium i Ultra, rozliczana w kredytach — 5-sekundowy klip w 720p Standard kosztuje 150 kredytów. Członkowie Ultra otrzymują 40% zniżki na wszystkie generacje Seedance 2.0.
Jak Seedance 2.0 porównuje się z Seedance 1.0?
To pełna przebudowa, a nie drobna aktualizacja. Główne ulepszenia: natywna generacja audio (1.0 nie miała żadnej), wejście multimodalne z do 12 zasobami (1.0 obsługiwała tylko tekst plus jeden opcjonalny obraz), wyższa rozdzielczość (2K vs. 1080p), lepsze renderowanie dłoni/kończyn oraz wskaźnik użytecznych wyników 90%+ przy pierwszej próbie.
Czy mogę używać Seedance 2.0 poza Chinami?
Bezpośredni dostęp przez aplikację Jimeng wymaga chińskich numerów telefonów i metod płatności, co tworzy tarcie dla użytkowników międzynarodowych. Łatwiejszą drogą jest używanie Seedance 2.0 przez PixVerse — bez ograniczeń regionalnych, bez potrzeby osobnego konta.
Jaka jest najlepsza struktura promptu dla Seedance 2.0?
Zacznij od: [Podmiot] + [Akcja] + [Ustawienie] + [Styl] + [Kamera] + [Oświetlenie]. Bądź konkretny w kierunkach kamery (“powolny dolly-in ze średniego ujęcia do zbliżenia”) i używaj składni referencji @image1 / @video1, gdy masz zasoby wizualne do prowadzenia wyniku. Dla sekwencji wieloujęciowych używaj notacji osi czasu: 0–4s: szerokie ujęcie, 4–8s: ujęcie śledzące itd.
Seedance 2.0 kontra PixVerse V6 — którego powinienem użyć?
To zależy od projektu. PixVerse V6 daje ci ponad 20 sparametryzowanych kontroli kamery, dostęp CLI dla przepływów pracy deweloperów oraz prostą globalną dostępność. Seedance 2.0 oferuje bogatsze wejścia multimodalne (12 zasobów), wyższą rozdzielczość (2K) i edycję wewnątrz wideo. Oba modele są na PixVerse, więc możesz je przetestować obok siebie.
Czy Seedance 2.0 generuje dźwięk?
Tak. Generuje dialog (z synchronizacją ust w ponad 7 językach), efekty dźwiękowe i dźwięk otoczenia w tym samym przebiegu co wideo. Nie jest potrzebny osobny krok produkcji audio. Dźwięk jest domyślnie włączony i można go wyłączyć, jeśli potrzebujesz tylko ścieżki wizualnej.
Jakie są główne ograniczenia Seedance 2.0?
Bariery dostępu regionalnego (głównie związane z chińskimi platformami), agresywna moderacja treści, API na etapie beta, brak wsparcia LoRA lub dostrajania, niepewne renderowanie tekstu wewnątrz wideo, niejasne warunki licencji komercyjnej, stroma krzywa uczenia się oraz maksymalna długość klipu 15 sekund. Konkretnie dla twórców treści społecznościowych: limit 15 sekund działa dla Reels, TikTok i Shorts, ale krzywa uczenia się i oznaczenia moderacji mogą spowalniać przepływy pracy o dużej objętości, gdzie szybkość liczy się bardziej niż precyzja na klip.
Czy warto zaktualizować do Seedance 2.0 dla profesjonalnych animatorów?
Dla animatorów 2D/3D, którzy potrzebują generacji opartej na referencjach — tak. System referencji @ odzwierciedla sposób, w jaki animatorzy już pracują: arkusze póz, obroty i klatki stylu stają się bezpośrednimi wejściami zamiast rzeczy, które trzeba opisać tekstem. Wskaźnik użytecznych wyników 90%+ przy pierwszej próbie znacznie skraca pętle iteracji. Jednak jeśli twój przepływ pracy zależy od dostrajania LoRA dla niestandardowych modeli postaci, Seedance 2.0 tego nie obsługuje. Dla pracy specyficznej dla anime, Hailuo AI i PixVerse V6 również dają silne wyniki przy niższym koszcie za klip. Decyzja sprowadza się do tego, czy kontrola wejścia wielorefererencyjnego uzasadnia wyższy koszt kredytów dla twojego konkretnego potoku.
Czy mogę używać API Seedance 2.0 w przepływach produkcyjnych?
API jest w publicznej becie od kwietnia 2026 roku. Obsługuje punkty końcowe text-to-video i image-to-video z podstawową kontrolą parametrów. Jednak limity zapytań, przełomowe zmiany między wersjami i niekompletna dokumentacja czynią je obecnie nieodpowiednim dla krytycznych dla produkcji zautomatyzowanych potoków. Do programowej generacji wideo dziś, API i CLI PixVerse oferują stabilny dostęp do Seedance 2.0 obok innych modeli — z spójnymi punktami końcowymi, udokumentowanymi limitami zapytań oraz integracją Claude Code / Cursor dla przepływów pracy deweloperów.
Ostateczny werdykt
Seedance 2.0 to prawdziwy krok naprzód dla generacji wideo AI — szczególnie dla twórców gotowych zainwestować czas w naukę jej multimodalnego systemu promptów. Przepływ pracy oparty na referencjach, natywny dźwięk oraz generacja wieloujęciowa oparta na osi czasu przybliżają ją bardziej do narzędzia produkcyjnego niż nowatorskiego generatora.
Kto powinien używać Seedance 2.0:
- Profesjonalni filmowcy i animatorzy: Najlepsza w swojej klasie dla narracji wielorefererencyjnych i wieloujęciowych. Krzywa uczenia się opłaca się, jeśli już myślisz w kategoriach list ujęć i tablic referencyjnych.
- Twórcy treści społecznościowych: Sprawdza się dla wysokiej jakości treści flagowych i wideo kampanii. Nadmiarowa dla codziennej objętości publikacji — rozważ PixVerse V6 lub Hailuo AI dla przepływów pracy nastawionych na szybkość.
- Korporacje i zespoły zależne od API: Poczekaj, aż API opuści betę, lub użyj warstwy API PixVerse dla stabilnego programowego dostępu do Seedance 2.0 już dziś.
- Przypadkowi użytkownicy i początkujący: Zacznij od PixVerse V6 lub Hailuo AI — prostsze systemy promptów, szybsze wyniki, niższy koszt na klip.
Nie jest dla wszystkich. Jeśli chcesz jednowierszowy prompt, aby szybko wyprodukować klip, modele takie jak Hailuo AI lub PixVerse V6 zaprowadzą cię tam szybciej i z mniejszym tarciem. Jeśli potrzebujesz wyjścia 4K, Veo 3 lub Kling 3.0 są lepszym wyborem. A jeśli kontrola kamery jest twoim priorytetem, PixVerse V6 obecnie oferuje bardziej precyzyjne i sparametryzowane opcje niż oparte na promptach podejście Seedance 2.0.
Najsilniejszym argumentem za wypróbowaniem Seedance 2.0 już teraz jest to, że nie musisz wybierać tylko jednego modelu. Na PixVerse możesz przepuścić ten sam koncept przez Seedance 2.0, V6, Kling i Veo, a następnie porównać go z każdym flagowym modelem w naszym zestawieniu generatorów wideo AI — porównać wyniki i użyć tego, co działa najlepiej dla każdego ujęcia. Ta elastyczność liczy się bardziej niż wynik benchmarku pojedynczego modelu.