Recensione Seedance 2.0: funzionalità, prompt e alternative nel 2026
Seedance 2.0 è uscito all’inizio di febbraio 2026 e ha conquistato X e Reddit in sole 48 ore. I creator pubblicavano clip che sembravano uscite da uno studio di produzione professionale, non da un modello IA. I benchmark hanno confermato l’hype: ELO di 1.269 in text-to-video e 1.351 in image-to-video, posizionandolo davanti a Kling 3.0, Veo 3 e Runway Gen-4.5 al lancio.
Due mesi dopo, la polvere si è posata. Abbiamo passato settimane a testare Seedance 2.0 in diversi scenari — scene cinematografiche, pubblicità di prodotti, ritratti, sequenze fantasy — e leggendo centinaia di post della community per distinguere ciò che funziona davvero da ciò che sembra solo impressionante in un demo reel. Questa recensione copre ciò che il modello fa bene, dove non riesce, cosa ne pensano gli utenti reali, come si confronta con il suo predecessore e i concorrenti, e sei casi d’uso con prompt che puoi testare subito.
Punti chiave:
- Seedance 2.0 accetta fino a 12 input misti (testo, immagini, video, audio) e genera clip da 4 a 15 secondi fino a 2K di risoluzione con audio nativo.
- Il comportamento della camera, la coerenza dei personaggi e il rendering di mani/arti sono notevolmente migliori rispetto a Seedance 1.0.
- L’accesso al di fuori della Cina resta un punto dolente. La moderazione dei contenuti aggressiva e una curva di apprendimento ripida per gli utenti occasionali sono lamentele comuni.
- Seedance 2.0 è ora disponibile su PixVerse, quindi puoi testarlo insieme a PixVerse V6, Kling, Veo e altri modelli senza cambiare piattaforma.
- Il prossimo modello di ByteDance, Seedance 2.5, sta già comparendo su piattaforme partner con la promessa di clip da 30 secondi e 50 input di riferimento — consulta la nostra guida a Seedance 2.5 per scoprire cosa è confermato e cosa no.
Cos’è Seedance 2.0?
Seedance 2.0 è un modello video IA multimodale creato da ByteDance. È stato lanciato il 7 febbraio 2026 come una ricostruzione completa — non un aggiornamento incrementale di Seedance 1.0.
La versione precedente elaborava testo e immagini attraverso pipeline separate. Seedance 2.0 sostituisce questo con un Transformer di Diffusione Multimodale unificato che codifica testo, immagine, audio e video in uno spazio di rappresentazione condiviso. In termini pratici, questo significa che il modello può prendere un prompt testuale, una foto di riferimento del tuo personaggio, un clip video che mostra il movimento di camera desiderato e una traccia audio, per poi combinare tutto questo in un unico output.
Il modello supporta fino a 12 asset di riferimento per generazione: 9 immagini, 3 video e 3 file audio. Li tagghi nel tuo prompt usando la sintassi @ (@image1, @video1, ecc.) per dire al modello esattamente dove applicare ogni riferimento.
Specifiche di output: da 4 a 15 secondi di video fino a 2K di risoluzione, con audio stereo nativo generato nello stesso passaggio delle immagini.
I punti di forza di Seedance 2.0: cosa fa bene
Input multimodale e il sistema di riferimenti @
Il sistema di riferimenti è la funzionalità di punta. Invece di descrivere tutto a parole sperando che il modello lo interpreti correttamente, puoi mostrargli cosa vuoi. Carica una foto del volto e taggala come @image1 nel tuo prompt, aggiungi un clip video che mostra la traiettoria della camera desiderata e includi una traccia musicale di sottofondo. Il modello legge ogni riferimento e lo applica dove hai specificato.
Questo funziona particolarmente bene per la coerenza dei personaggi tra generazioni multiple. Carica lo stesso riferimento del volto e il personaggio mantiene il suo aspetto — qualcosa che richiede ancora soluzioni alternative sulla maggior parte dei modelli concorrenti.
Comportamento cinematografico della camera
Seedance 2.0 gestisce il movimento della camera in modo più naturale rispetto alla maggior parte dei modelli che abbiamo testato. Carrellate, zoom in avanti e orbite lente risultano fluide e intenzionali piuttosto che casuali. Un utente Reddit ha riferito di aver ricreato i movimenti di camera della serie Severance con risultati “sorprendentemente accurati”.
Il modello risponde bene al linguaggio di camera specifico nei prompt: “lento dolly-in da piano medio a primo piano” o “carrellata dal basso” producono risultati prevedibili. Istruzioni vaghe come “cinematografico” ti danno meno controllo, ma l’output tende comunque a qualcosa di ragionevole di default.
Come controllare il movimento di camera in Seedance 2.0:
- Usa termini di cinematografia precisi nel tuo prompt. Invece di “camera in movimento”, scrivi “lento dolly-in da campo largo a mezzo primo piano” o “carrellata dal basso che si muove da sinistra a destra”. Il modello riconosce la terminologia cinematografica standard.
- Carica un riferimento @video che mostri il movimento desiderato. Registra un clip approssimativo (anche dal telefono) che mostri la traiettoria, taggalo
@video1e descrivilo nel prompt: “La camera segue la traiettoria mostrata in @video1”. - Usa la notazione a timeline per sequenze complesse. Scrivi
0-4s: campo largo statico→4-8s: lento avvicinamento a piano medio→8-12s: orbita attorno al soggetto. Il modello genera ogni segmento come parte di un clip coerente.
A differenza del Motion Brush di Runway Gen-4.5 (che consente di dipingere il movimento a livello regionale), Seedance 2.0 non offre un controllo del movimento fotogramma per fotogramma. Il comportamento della camera è controllato interamente tramite il linguaggio del prompt e i riferimenti video — meno granulare, ma più rapido da iterare.
Sincronizzazione nativa audio-video
Seedance 2.0 genera audio e video simultaneamente attraverso una diffusione congiunta. Questo include:
- Dialoghi con sincronizzazione labiale in oltre 7 lingue
- Effetti sonori sincronizzati con le azioni sullo schermo
- Paesaggi sonori ambientali e musica di sottofondo che corrispondono all’atmosfera visiva
La qualità della sincronizzazione labiale è solida nei nostri test — notevolmente migliore rispetto agli strumenti di doppiaggio in post-produzione. Non è perfetta, ma elimina la necessità di una pipeline audio separata nella maggior parte dei casi.
Coerenza temporale e realismo fisico
Personaggi e oggetti mantengono la loro forma tra i fotogrammi con un flickering minimo. Il rendering delle mani — storicamente l’anello debole del video IA — è notevolmente migliorato rispetto alla versione 1.0. Le dita mantengono il numero corretto più spesso, e i movimenti degli arti appaiono ponderati piuttosto che fluttuanti.
Il drappeggio dei tessuti, il comportamento dell’acqua e la fisica delle collisioni risultano tutti più solidi. Questo conta per qualsiasi contenuto che vada oltre il visivo astratto. Se stai generando una pubblicità di prodotto o una narrazione incentrata sul personaggio, una fisica credibile fa la differenza tra una “demo IA impressionante” e “materiale utilizzabile”.
Narrazione multi-scena
Puoi strutturare il tuo prompt come una timeline — 0-4s: campo largo di apertura, 4-8s: carrellata in piano medio, ecc. — e il modello genera ogni segmento come una sequenza coerente. I personaggi rimangono coerenti e le transizioni tra le scene sono fluide anziché brusche.
Questo rappresenta un vero cambiamento nel flusso di lavoro. I modelli precedenti richiedevano di generare ogni scena individualmente e unirle in post-produzione. Seedance 2.0 gestisce il sequenziamento in modo nativo.
Editing all’interno del video
Puoi sostituire personaggi o oggetti in un video esistente senza rigenerare l’intero clip. Devi cambiare l’abito del tuo personaggio? Sostituire lo sfondo? Il modello modifica l’elemento target mantenendo tutto il resto intatto. Questo non è disponibile sulla maggior parte dei modelli concorrenti e fa risparmiare un tempo considerevole di iterazione.
Seedance 2.0 in sintesi
| Specifica | Dettaglio |
|---|---|
| Sviluppatore | ByteDance |
| Data di rilascio | 7 febbraio 2026 |
| Architettura | Transformer di Diffusione Multimodale unificato |
| Input | Testo + fino a 9 immagini + 3 video + 3 file audio |
| Risoluzione massima | 2K |
| Durata | 4-15 secondi |
| Audio nativo | Sì (dialogo, effetti, ambiente, musica) |
| Lingue di sincronizzazione labiale | 7+ |
| Editing all’interno del video | Sì (sostituzione personaggio/oggetto) |
Dove Seedance 2.0 non è all’altezza
Nessun modello viene lanciato senza compromessi. Ecco quelli che contano.
L’accesso regionale è limitato. Seedance 2.0 è stato lanciato principalmente attraverso l’ecosistema cinese di ByteDance (l’app Jimeng). Gli utenti internazionali affrontano ritardi di verifica, blocchi regionali e frizioni nei pagamenti. La soluzione più semplice è accedervi tramite PixVerse, che rimuove completamente le barriere geografiche.
La moderazione dei contenuti è aggressiva. Diversi utenti segnalano prompt bloccati per contenuti innocui. Le generazioni relative ai volti hanno particolarmente più probabilità di attivare i filtri. Un commento su Reddit lo ha riassunto così: “La censura ha semplicemente rovinato Seedance 2.0”. Questo è un vero collo di bottiglia per il lavoro creativo commerciale in cui serve un output coerente.
La curva di apprendimento è ripida. Se vuoi semplicemente digitare una frase e ottenere un video, Seedance 2.0 non è il punto di partenza più semplice. Il sistema di riferimenti @, i prompt a timeline e gli input multimodali sono potenti — ma richiedono tempo per essere appresi. I recensori lo valutano costantemente alto per i professionisti (8,5/10) e basso per gli utenti occasionali (5/10).
L’API è ancora in beta. I team aziendali che necessitano di un accesso programmatico stabile dovrebbero prepararsi a modifiche dirompenti e sorprese sui limiti di velocità.
Il rendering del testo nel video non è affidabile. Se la tua scena include testo a schermo — un’insegna, una scritta di titolo, un’etichetta di prodotto — aspettati risultati incoerenti. Questo è un punto debole condiviso dalla maggior parte dei modelli video nel 2026, ma va segnalato.
Nessun supporto LoRA. Non puoi affinare il modello con dataset personalizzati. Se hai bisogno di uno stile visivo specifico o di un look di marca che il modello base non copre, sei limitato all’ingegneria dei prompt e alle immagini di riferimento.
Massimo 15 secondi per clip. Abbastanza lungo per contenuti social e pubblicità, ma corto per lavori narrativi. Il prompting multi-scena aiuta, ma resti comunque limitato a 15 secondi totali per generazione.
I termini di licenza commerciale non sono chiari. ByteDance non ha pubblicato diritti di utilizzo commerciale espliciti per gli output di Seedance 2.0. I termini di servizio di Jimeng concedono diritti di utilizzo per i contenuti generati tramite la piattaforma, ma i dettagli su ridistribuzione, opere derivate e responsabilità nella pubblicità commerciale non sono affrontati esplicitamente. Se generi tramite PixVerse, si applica all’output la licenza commerciale di PixVerse. Per lavori commerciali ad alto rischio — pubblicità di prodotti, materiali per clienti, trasmissioni — conferma i diritti prima di pubblicare.
Come correggere gli errori comuni di Seedance 2.0
Se stai riscontrando problemi, non sei solo. Questi sono i problemi più frequentemente segnalati e le loro soluzioni, basati sui report della community e sui nostri test.
| Problema | Causa probabile | Soluzione |
|---|---|---|
| Prompt segnalato / rifiutato dalla moderazione | Parole chiave relative al volto o formulazioni ambigue che attivano i filtri sui contenuti | Rimuovi descrizioni esplicite del volto. Usa riferimenti @image invece di descrivere i volti nel testo. Evita parole come “ritratto realistico” in combinazione con nomi di persone specifiche. |
| Fotogrammi neri o generazione fallita | Prompt troppo complesso per la durata/risoluzione selezionata | Riduci a un’azione ogni 4-5 secondi. Abbassa la risoluzione da 2K a 720p. Dividi i prompt multi-scena in segmenti più brevi. |
| Il volto del personaggio cambia tra le scene | Nessun ancoraggio di riferimento coerente | Carica la stessa foto del volto come @image1 in ogni generazione. Fai riferimento esplicito: “La persona in @image1 cammina verso la camera”. |
| L’audio non è sincronizzato con il video | Disallineamento della diffusione congiunta in scene complesse di sincronizzazione labiale | Rigenera con l’audio disattivato, quindi aggiungi l’audio in un passaggio separato. In alternativa, semplifica il dialogo in frasi più brevi. |
| Errore “regione non supportata” o di pagamento | Jimeng richiede la verifica cinese | Accedi invece a Seedance 2.0 tramite PixVerse — nessun blocco regionale, nessun numero di telefono cinese necessario. |
| Mani/dita distorte | Interazioni manuali complesse senza guida di riferimento | Aggiungi un’immagine di riferimento che mostri la posa della mano desiderata. Evita prompt che richiedono più di un’interazione manuale simultanea. |
| L’output sembra “generato dall’IA” o plasticoso | Eccessiva dipendenza da parole chiave di stile senza fondamento fisico | Aggiungi dettagli fisici: materiali specifici, condizioni di illuminazione reali, tipo di obiettivo. Usa “girato con Arri Alexa, 35mm” invece del generico “cinematografico”. |
Se la tua generazione fallisce costantemente dopo 3 o più tentativi con la stessa struttura di prompt, il problema è probabilmente la complessità del prompt piuttosto che un bug della piattaforma. Semplifica, genera, poi reintroduci gradualmente la complessità.
Quanto costa Seedance 2.0?
Seedance 2.0 è gratuito su Jimeng con generazioni giornaliere limitate, e costa 150 crediti per clip di 5 secondi (720p Standard) su PixVerse. Ecco la ripartizione completa dei prezzi per entrambi i metodi di accesso.
Su Jimeng (la piattaforma nativa di ByteDance):
| Piano | Prezzo mensile | Generazioni giornaliere | Note |
|---|---|---|---|
| Gratuito | 0 $ | ~5-10 clip/giorno | Bloccato sulla Cina, richiede telefono cinese |
| Basic | ~9,99 $ | 50+ clip/giorno | Accesso a risoluzione superiore |
| Pro | ~29,99 $ | 200+ clip/giorno | Coda prioritaria |
| Premium | ~49,99 $ | Illimitato | Tutte le funzionalità, generazione più veloce |
Su PixVerse (accesso globale, nessun blocco regionale):
| Livello | 480p | 720p | 1080p |
|---|---|---|---|
| Standard | 15 crediti/s | 30 crediti/s | Disponibile |
| Fast | 10 crediti/s | 20 crediti/s | N/D |
Un clip di 5 secondi in 720p Standard costa 150 crediti. La modalità Fast costa 100 crediti per lo stesso clip. I membri Pro (9,99 $/mese), Premium (24,99 $/mese) e Ultra (49,99 $/mese) possono accedere a Seedance 2.0. I membri Ultra ottengono uno sconto del 40% sui crediti per tutte le generazioni.
Confronto dei costi per clip di 5 secondi a 720p:
| Modello | Piattaforma | Costo approssimativo |
|---|---|---|
| Seedance 2.0 Standard | PixVerse | ~0,75 $ (150 crediti) |
| Seedance 2.0 Fast | PixVerse | ~0,50 $ (100 crediti) |
| PixVerse V6 | PixVerse | ~0,35 $ (70 crediti) |
| Kling 3.0 | Kling | Incluso nel piano da 10 $/mese |
| Hailuo AI | MiniMax | Incluso nel piano da 9,99 $/mese |
| Sora 2 | OpenAI | ~0,50-2,50 $ |
A circa 0,15 $ al secondo (Standard 720p), Seedance 2.0 costa circa il doppio per clip rispetto a PixVerse V6, ma include un input multimodale — rendendolo il più conveniente per progetti che altrimenti richiederebbero più passaggi di corrispondenza dei riferimenti o un’ampia post-produzione.
Cosa dice la community
Feedback di creator e professionisti
I creator professionisti — registi, produttori di videoclip musicali, agenzie pubblicitarie — sono il gruppo di utenti più entusiasta. Il sistema di riferimenti multimodale e i prompt a timeline corrispondono al modo in cui già pensano alla produzione: in termini di scene, riferimenti e sequenze piuttosto che descrizioni testuali.
Una recensione ha valutato Seedance 2.0 con 8,5/10 per i professionisti creativi che necessitano di un controllo granulare. Un primo tester su X ha osservato: “Il mio co-fondatore ha passato un’intera giornata cercando di ottenere questo effetto. Seedance 2.0 lo ha fatto in 5 minuti”.
Il modello viene descritto come qualcosa che “pensa come un regista” — risponde a indicazioni a livello di scena invece di generare semplicemente qualcosa che corrisponda vagamente al tuo prompt. Per i team che già lavorano in flussi di pre-produzione, questo è un cambiamento significativo.
Reazioni sui social media e nei forum
Le community Reddit (r/SeedanceAI_Lab, r/Seedance_v2) sono attive e in crescita. I risultati più condivisi tendono a essere clip cinematografiche che sembrano più vicine a riprese dal vivo rispetto al tipico video IA.
Le lamentele comuni sui social media coincidono con i nostri risultati: difficoltà di accesso al di fuori della Cina, falsi positivi della moderazione e il tempo necessario per imparare il sistema di prompt. Diversi thread lo paragonano ad “avere una fotocamera potente ma dover imparare la modalità manuale prima di ottenere buoni scatti”.
La controversia sui diritti d’autore
Entro pochi giorni dal lancio, Disney ha inviato a ByteDance una lettera di diffida, sostenendo che Seedance 2.0 generasse personaggi Disney a partire dai suoi dati di addestramento. La Motion Picture Association e SAG-AFTRA hanno rilasciato dichiarazioni pubbliche. I video virali di somiglianze di celebrità generate dall’IA hanno aggiunto benzina sul fuoco.
Questa è una questione legale in corso in tutto il settore del video IA, non specifica di Seedance 2.0. Ma vale la pena tenerla d’occhio se prevedi di usare il modello per lavori commerciali che coinvolgono personaggi o somiglianze riconoscibili.
Seedance 2.0 vs. Seedance 1.0: cosa è cambiato
Il salto da 1.0 a 2.0 è una ricostruzione architettonica completa. Ecco come si confrontano:
| Funzionalità | Seedance 1.0 | Seedance 2.0 |
|---|---|---|
| Architettura | Pipeline separate per testo e immagine | Transformer di Diffusione Multimodale unificato |
| Input testo | Sì | Sì |
| Input immagine | Una singola immagine opzionale | Fino a 9 immagini con controllo tag @ |
| Input video | No | Fino a 3 video di riferimento |
| Input audio | No | Fino a 3 file audio |
| Output audio nativo | No | Sì (dialogo, effetti, ambiente, musica) |
| Risoluzione massima | 1080p | 2K |
| Durata | 5-10 secondi | 4-15 secondi |
| Multi-scena | Base | Storyboard a timeline con coerenza tra scene |
| Qualità mani/arti | Artefatti frequenti | Notevolmente migliorata |
| Editing all’interno del video | No | Sì (sostituzione personaggio/oggetto) |
| Tasso di output utilizzabile | ~60% | 90%+ al primo tentativo |
I due maggiori aggiornamenti nell’uso quotidiano sono l’audio nativo (la 1.0 non ne aveva) e il sistema di riferimenti multimodale (la 1.0 era limitata a una singola immagine opzionale). Se hai provato la 1.0 e l’hai abbandonata, la 2.0 è uno strumento fondamentalmente diverso.
E Seedance 2.5?
ByteDance non sta con le mani in mano. Una versione più recente — con il marchio Seedance 2.5 — è già apparsa sulle pagine pubbliche di Dreamina/CapCut, con la promessa di clip standard da 30 secondi (contro il limite di 15 secondi della 2.0), una modalità beta per video lunghi da 180 secondi, fino a 50 input di riferimento multimodale e un nuovo sistema di riferimento-a-video (R2V) per controllare il movimento dei personaggi tramite riprese in green-screen o con modello bianco. Nulla di tutto ciò è ancora verificato in modo indipendente — si tratta di testo del fornitore, non di test di laboratorio — quindi tratta queste specifiche come indicative piuttosto che confermate. Se questi numeri dovessero essere confermati, la 2.5 rappresenterebbe un salto ancora maggiore rispetto alla 2.0 di quanto la 2.0 lo sia stata rispetto alla 1.0. Analizziamo esattamente cosa è confermato e cosa resta da verificare nella nostra guida a Seedance 2.5. Finché la 2.5 non sarà distribuita su larga scala con risultati verificati, tutto quanto scritto in questa recensione si applica ancora al modello 2.0 disponibile oggi.
Casi d’uso di Seedance 2.0: sei prompt testati
Abbiamo testato Seedance 2.0 in sei scenari che coprono le esigenze creative più comuni. Ogni prompt qui sotto è pronto per essere copiato e testato. Per ciascuno, descriviamo cosa abbiamo ottenuto, quanto tempo ci è voluto e cosa ha funzionato o meno.
Tutti i test sono stati eseguiti su PixVerse usando Seedance 2.0 Standard a 720p, 5-8 secondi, formato 16:9, salvo diversa indicazione.
Scena cinematografica
Questo prompt testa il comportamento della camera, l’atmosfera e il rendering dei personaggi in condizioni buie e ad alto contrasto — il tipo di scena che espone rapidamente gli artefatti di movimento.
Prompt:
A retired detective in a long dark coat walks through a rain-soaked alley at night. Neon signs reflect red and blue on the wet cobblestones. He pauses, lights a cigarette, and glances over his shoulder. Slow push-in from wide shot to medium close-up. Film noir style, anamorphic lens flare, teal-orange color grading, film grain.
Cosa abbiamo ottenuto: L’avvicinamento della camera era fluido e stabile — senza scatti o salti improvvisi. I riflessi della pioggia sul ciottolato bagnato risultavano convincenti, con i colori al neon che si diffondevano sulla superficie bagnata come dovrebbero. Il cappotto del detective si muoveva naturalmente mentre camminava, e il gesto di accendere una sigaretta è stato gestito senza alcuna distorsione delle mani. L’audio ambientale includeva pioggia e rumore di città in lontananza, in perfetta sintonia con la scena. La generazione ha richiesto circa 70 secondi in Standard. Nel complesso, questo è il tipo di output che potresti inserire in un mood reel o in un pitch di cortometraggio senza troppo lavoro di post-produzione.
Spot pubblicitario di prodotto
Le riprese di prodotto sono un test pratico per la simulazione fisica: la luce colpisce correttamente la superficie, la rotazione risulta meccanicamente fluida e il materiale appare come dovrebbe?
Prompt:
A luxury perfume bottle rotates slowly on a black marble surface. Golden liquid catches the light as it turns. Soft particles of gold dust float in the air around it. Macro close-up, slow 360-degree orbit camera. Studio lighting with warm rim light, high-end commercial photography style.
Cosa abbiamo ottenuto: La rifrazione del vetro e il comportamento del liquido all’interno della bottiglia erano sorprendentemente precisi. Le particelle dorate fluttuavano a un ritmo naturale, e la superficie di marmo presentava una texture granulosa visibile. La camera orbitante è rimasta fluida durante l’intera rotazione. La luce colpiva il vetro con le angolazioni giuste, producendo il tipo di riflessi caustici che ci si aspetterebbe da un vero set fotografico professionale. Tempo totale di generazione: circa 65 secondi. Come prima bozza di un video concettuale di prodotto, questo fa risparmiare ore rispetto all’impostazione di un rendering 3D.
Videoclip musicale
I videoclip musicali richiedono movimento espressivo, cambiamenti di illuminazione drammatici e la capacità di mantenere l’aspetto di un personaggio durante un movimento dinamico. È qui che la coerenza temporale viene messa a dura prova.
Prompt:
A female singer in a flowing red silk dress performs on a rooftop at sunset. City skyline stretches behind her. Wind blows her hair and dress dramatically. She sings with emotional intensity, arms spread wide. Dynamic tracking shot circling around her. Golden hour backlighting, lens flare, vibrant warm tones.
Cosa abbiamo ottenuto: La fisica dell’abito è stata il punto di forza — la seta rossa che catturava il vento e la luce in un modo che sembrava fisico, non procedurale. La carrellata orbitale attorno alla cantante era fluida, e il suo volto è rimasto coerente durante l’intera rotazione. Il movimento dei capelli sembrava naturale e corrispondeva alla direzione del vento sull’abito, un dettaglio che molti modelli sbagliano. L’audio nativo ha generato una traccia musicale ambientale che corrispondeva al tempo dei suoi movimenti. Generazione: circa 75 secondi. Se stai costruendo un moodboard o un video concettuale per un progetto musicale, questo ti porta all’80% del risultato in una sola generazione.
Ritratto di personaggio in movimento
Il movimento sottile è più difficile dell’azione drammatica per la maggior parte dei modelli video. I piccoli gesti — una rotazione della testa, mani che esaminano un oggetto — espongono l’instabilità temporale che le scene con movimento rapido possono nascondere.
Prompt:
An elderly Japanese craftsman in a traditional wooden workshop, morning light streaming through paper screens. He slowly lifts a hand-forged ceramic tea bowl, examining it with quiet pride. His weathered hands rotate the bowl gently. Close-up of his hands, then slow tilt up to reveal his face. Wabi-sabi aesthetic, warm natural light, documentary portrait quality.
Cosa abbiamo ottenuto: Questo è stato uno dei risultati più solidi nei nostri test. Le mani — tipicamente l’anello più debole nel video IA — sono rimaste stabili con il numero corretto di dita e un movimento articolare naturale per tutto il clip. L’inclinazione della camera dalle mani al volto era fluida, e la transizione di messa a fuoco sembrava un vero cambio di fuoco dell’obiettivo. La luce del mattino attraverso gli schermi di carta proiettava ombre morbide e uniformi. Il modello ha aggiunto da sé sottili suoni ambientali dell’officina: un uccello in lontananza, il tintinnio morbido della ceramica. La texture della pelle sulle mani segnate dal tempo appariva realistica senza eccessiva nitidezza. Generazione: circa 80 secondi. Per contenuti in stile documentaristico o narrazione di marca, questo livello di sottigliezza è esattamente ciò di cui hai bisogno.
Natura e paesaggio
Le riprese aeree e paesaggistiche mettono alla prova la coerenza su larga scala: il modello può mantenere un ambiente coerente attraverso una camera in movimento per diversi secondi?
Prompt:
Aerial drone shot gliding over a misty mountain valley at sunrise. Layers of fog roll between emerald green peaks. A winding river reflects the golden morning light below. Eagles soar through the frame at eye level. Smooth forward tracking with slight descent. Epic landscape, volumetric fog, golden hour lighting.
Cosa abbiamo ottenuto: Gli strati di nebbia si muovevano in modo indipendente e a velocità diverse, conferendo alla scena una profondità reale invece dell’aspetto di un dipinto opaco piatto. Il riflesso del fiume si aggiornava correttamente man mano che la camera avanzava — un dettaglio che richiede consapevolezza spaziale da parte del modello. La tavolozza di colori complessiva — toni dorati caldi che incontrano montagne blu-verdi fredde — è stata gestita bene, e la nebbia volumetrica appariva tridimensionale. L’audio includeva vento e richiami di uccelli in lontananza in linea con l’ambiente. Questa è stata anche la generazione più veloce del nostro lotto: circa 55 secondi. Il risultato si avvicina a ciò che otterresti da una ripresa professionale con drone, meno il budget di viaggio.
Anime e fantasy
I contenuti stilizzati rappresentano una sfida diversa dal fotorealismo. Il modello deve mantenere uno stile artistico coerente (cel-shading, linee di velocità, colore piatto) generando al contempo un movimento credibile.
Prompt:
An anime warrior princess stands atop a cliff overlooking a burning medieval city at night. Her long silver hair and crimson cape billow in the wind. She draws a glowing blue katana, electricity crackling along the blade. Cherry blossom petals swirl around her. Dynamic low-angle shot with slow push-in. Cel-shading style, vibrant neon accents, dramatic speed lines.
Cosa abbiamo ottenuto: Il cel-shading è rimasto coerente per tutto il clip — senza la fusione tra stile anime e fotorealistico, un problema comune in altri modelli. L’estrazione della katana era fluida, e l’effetto elettrico lungo la lama sembrava appartenere a un vero anime piuttosto che a una sovrapposizione luminosa generica. I petali di ciliegio si muovevano in modo indipendente, alcuni catturando il bagliore del fuoco della città in fiamme sottostante. L’audio includeva un fruscio drammatico di spada per l’estrazione che coincideva esattamente con il movimento. Generazione: circa 70 secondi. La coerenza stilistica è la cosa più difficile da ottenere negli anime generati dall’IA, e Seedance 2.0 l’ha gestita meglio della maggior parte dei modelli che abbiamo testato.
Alternative a Seedance 2.0: come si confrontano i migliori generatori video IA nel 2026
Seedance 2.0 è un modello valido, ma non è l’unica opzione — e a seconda delle tue esigenze, potrebbe non essere la scelta migliore. Di seguito confrontiamo Seedance 2.0 con PixVerse V6, Runway Gen-4.5, Pika 2.2, Luma Ray3 e altri cinque modelli leader in termini di risoluzione, prezzi, audio e adattabilità al flusso di lavoro.
PixVerse V6 — e Seedance 2.0 su PixVerse
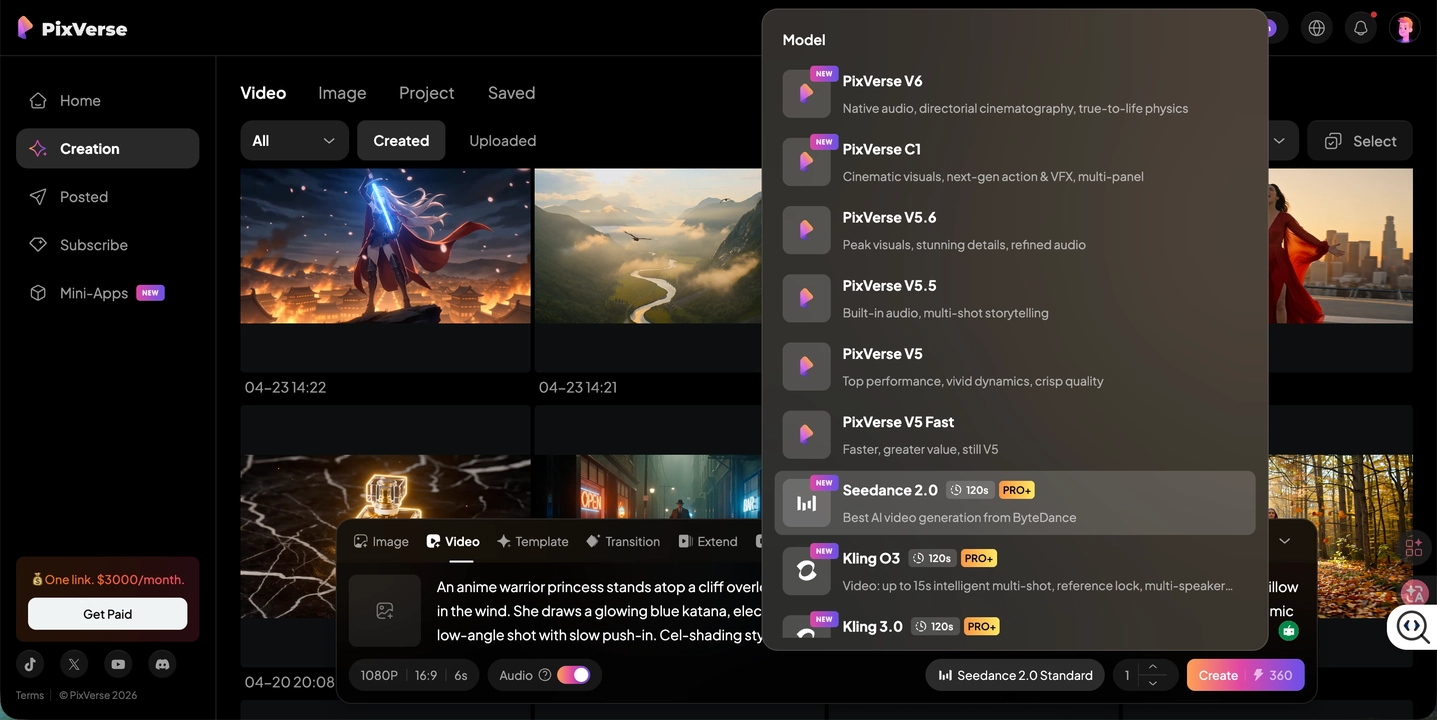
Prima di confrontare i singoli modelli, vale la pena affrontare un problema pratico: ogni modello vive sulla propria piattaforma con il proprio account, i propri prezzi e il proprio flusso di lavoro. Se vuoi testare Seedance 2.0 contro Kling 3.0 per una pubblicità di prodotto, normalmente hai bisogno di due account e due set di crediti.
PixVerse risolve questo problema. Seedance 2.0 è stato lanciato su PixVerse il 13 aprile 2026, unendosi a Kling O3, Veo 3.1, Sora 2 e altri modelli. Un account, un saldo crediti, confronto fianco a fianco.
Seedance 2.0 su PixVerse è disponibile in due livelli:
| Livello | 480p | 720p | 1080p |
|---|---|---|---|
| Standard | 15 crediti/s | 30 crediti/s | Disponibile |
| Fast | 10 crediti/s | 20 crediti/s | N/D |
Un clip di 5 secondi in 720p Standard costa 150 crediti. Fast costa 100 crediti per lo stesso clip. I membri Pro, Premium e Ultra possono accedere a Seedance 2.0. I membri Ultra ottengono uno sconto del 40% sui crediti per tutte le generazioni.
Oltre a ospitare modelli di terze parti, PixVerse V6 è di per sé una valida alternativa. Adotta un approccio diverso — mentre Seedance 2.0 eccelle nella precisione multi-riferimento, PixVerse V6 si concentra sul controllo della camera e sulla produzione multi-scena.
| Funzionalità | PixVerse V6 | Seedance 2.0 |
|---|---|---|
| Durata massima | 15 secondi | 15 secondi |
| Controllo camera | 20+ controlli parametrizzati (dolly, gru, orbita, carrellata) | Descrizione basata su prompt |
| Audio nativo | Sì | Sì (sincronizzazione labiale in 7+ lingue) |
| Tipi di input | Testo + immagine; motore multi-scena | Testo + 9 immagini + 3 video + 3 audio |
| Editing all’interno del video | No | Sì |
| Multi-scena | Film a prompt singolo con audio nativo | Storyboard a timeline |
| Accesso | Web, mobile, API, CLI | Jimeng (Cina) o PixVerse |
| Costo (1080p, al secondo) | 14 crediti (~0,07 $) | 30 crediti Standard (~0,15 $) |
Scegli V6 quando: hai bisogno di movimenti di camera precisi, integrazione CLI per flussi di lavoro di sviluppo (funziona con Claude Code, Codex, Cursor) o accesso globale senza restrizioni.
Scegli Seedance 2.0 quando: hai bisogno di controllo dell’input multi-riferimento, output a risoluzione più alta o editing all’interno del video.
Entrambi sono disponibili su PixVerse, quindi non devi vincolarti a uno solo.
Sora 2 (OpenAI)
Sora 2 è il più forte nella narrazione e nella simulazione fisica. L’aderenza al prompt è alta, e il modello gestisce scene emotive — momenti guidati dal dialogo, interazioni sottili tra personaggi — meglio della maggior parte dei concorrenti. Richiede un abbonamento ChatGPT Plus (20 $/mese) o Pro (200 $/mese). Il prezzo dell’API varia da 0,10 a 0,50 $ al secondo a seconda della risoluzione. Output massimo: 1080p, fino a 20 secondi.
Veo 3 (Google)
Veo 3 è il campione della risoluzione: output nativo in 4K con opzione a 60fps e audio spaziale. Si integra perfettamente nei flussi di lavoro Google Cloud, il che lo rende interessante per i team aziendali già in quell’ecosistema. Il compromesso è la durata — i clip sono limitati a 8 secondi, il che ne limita l’utilità per i contenuti narrativi. I prezzi partono da 0,05 $/s per il livello Lite.
Kling 3.0 (Kuaishou)
Kling 3.0 offre il miglior rapporto qualità-prezzo per clip. 4K nativo a 60fps, sincronizzazione labiale multilingue e un Multi-Shot AI Director che gestisce fino a sei tagli di camera in una singola generazione da 15 secondi. Element Binding mantiene coerenti personaggi e oggetti tra le scene. I piani partono da 10 $/mese. Il livello gratuito esiste, ma è limitato a Kling 2.0.
Runway Gen-4.5
Runway ha il toolkit di editing più maturo. Motion Brush ti dà un controllo a livello di fotogramma su come si muovono regioni specifiche del tuo video. Se lavori già in una pipeline di post-produzione con After Effects o DaVinci Resolve, Runway si integra naturalmente. Lo svantaggio: risoluzione massima di 720p e limite di clip a 10 secondi. Il prezzo dell’API è di circa 0,12 $ al secondo.
Hailuo AI (MiniMax)
Hailuo è l’opzione veloce. I tempi di generazione sono di 30-90 secondi per clip — i più veloci in questo confronto. Si classifica al #1 su WorldModelBench per la simulazione fisica e gestisce bene i contenuti anime e stilizzati. La risoluzione massima è 1080p, ma i clip sono limitati a 10 secondi. I piani partono da 9,99 $/mese.
Pika 2.2 (Pika Labs)
Pika 2.2 si concentra sull’editing creativo piuttosto che sulla generazione grezza. La sua funzione Scene-to-Scene ti consente di trasformare filmati esistenti in stili visivi completamente nuovi, e Lip Sync gestisce la sovrapposizione del dialogo senza richiedere una rigenerazione completa del video. Il sistema Pikaffects applica trasformazioni stilizzate (schiacciare, sciogliere, esplodere) popolari per i contenuti sui social media. A 8 $/mese per il piano standard, è una delle opzioni più economiche. La risoluzione massima è 1080p con clip fino a 10 secondi. Il compromesso: la qualità di generazione grezza e la simulazione fisica di Pika restano indietro rispetto a Seedance 2.0, Kling e Veo nei benchmark.
Luma Ray3 (Dream Machine)
Ray3 punta alla post-produzione professionale. 1080p nativo con HDR, output di fotogrammi EXR a 16 bit per pipeline di color grading, e una Draft Mode che genera 5 volte più velocemente a un costo 5 volte inferiore per la prototipazione rapida. La funzione Modify Video si estende fino a 18 secondi. I piani partono da 9,99 $/mese.
Confronto rapido a tre
Cerchi un confronto diretto testa a testa? Ecco come si dividono i modelli principali in base al loro punto di forza principale:
- Precisione multi-riferimento + narrazione cinematografica: Seedance 2.0
- Controllo del movimento a livello di fotogramma + integrazione con la post-produzione: Runway Gen-4.5
- Flussi di lavoro HDR/EXR + prototipazione rapida: Luma Ray3
- Effetti creativi + contenuti social a basso budget: Pika 2.2
- Controllo camera parametrizzato + accesso CLI/sviluppatore: PixVerse V6
Tabella comparativa completa
| Modello | Durata massima | Audio nativo | Prezzo di partenza | Ideale per |
|---|---|---|---|---|
| Seedance 2.0 | 15s | Sì | ~150 crediti/clip su PixVerse | Controllo multi-riferimento, narrazioni cinematografiche |
| PixVerse V6 | 15s | Sì | ~70 crediti/clip | Controllo camera, film multi-scena, flussi CLI |
| Sora 2 | 20s | No | 0,10 $/s | Narrazione, simulazione fisica |
| Veo 3 | 8s | Sì (spaziale) | 0,05 $/s | Fotorealismo 4K, enterprise |
| Kling 3.0 | 15s | Sì | 10 $/mese | Rapporto qualità-prezzo, formato lungo, multi-scena |
| Runway Gen-4.5 | 10s | No | ~0,12 $/s | Motion Brush, strumenti per filmmaker |
| Pika 2.2 | 10s | No | 8 $/mese | Effetti creativi, contenuti social, budget |
| Hailuo AI | 10s | No | 9,99 $/mese | Velocità, budget, fisica |
| Luma Ray3 | ~10,5s | No | 9,99 $/mese | Flussi HDR, post-produzione |
Prova Seedance 2.0 su PixVerse
Domande frequenti
Cos’è Seedance 2.0?
Seedance 2.0 è un modello video IA multimodale di ByteDance, rilasciato a febbraio 2026. Genera clip video da 4 a 15 secondi fino a 2K di risoluzione con audio nativo. Il modello accetta testo, immagini, video e audio come input combinati — fino a 12 asset di riferimento per generazione.
Seedance 2.0 è gratuito?
Seedance 2.0 offre livelli gratuiti e a pagamento sulla sua piattaforma nativa (fino a 49,99 $/mese). Su PixVerse è disponibile per i membri Pro, Premium e Ultra, fatturato a crediti — un clip di 5 secondi in 720p Standard costa 150 crediti. I membri Ultra ottengono uno sconto del 40% su tutte le generazioni Seedance 2.0.
Come si confronta Seedance 2.0 con Seedance 1.0?
È una ricostruzione completa, non un semplice aggiornamento minore. I principali miglioramenti: generazione audio nativa (la 1.0 non ne aveva nessuna), input multimodale con fino a 12 asset (la 1.0 supportava solo testo più un’immagine opzionale), risoluzione superiore (2K contro 1080p), migliore rendering di mani/arti e un tasso di output utilizzabile del 90%+ al primo tentativo.
Posso usare Seedance 2.0 al di fuori della Cina?
L’accesso diretto tramite l’app Jimeng richiede numeri di telefono e metodi di pagamento cinesi, il che crea attrito per gli utenti internazionali. La strada più semplice è usare Seedance 2.0 tramite PixVerse — nessuna restrizione regionale, nessun account separato necessario.
Qual è la migliore struttura di prompt per Seedance 2.0?
Inizia con: [Soggetto] + [Azione] + [Ambientazione] + [Stile] + [Camera] + [Illuminazione]. Sii specifico con le indicazioni di camera (“lento dolly-in da piano medio a primo piano”) e usa la sintassi di riferimento @image1 / @video1 quando hai asset visivi per guidare l’output. Per sequenze multi-scena, usa la notazione a timeline: 0-4s: campo largo, 4-8s: carrellata, ecc.
Seedance 2.0 vs. PixVerse V6 — quale dovrei usare?
Dipende dal progetto. PixVerse V6 offre più di 20 controlli di camera parametrizzati, accesso CLI per flussi di lavoro di sviluppo e una disponibilità globale semplice. Seedance 2.0 offre input multimodali più ricchi (12 asset), risoluzione superiore (2K) ed editing all’interno del video. Entrambi i modelli sono su PixVerse, quindi puoi testarli fianco a fianco.
Seedance 2.0 genera audio?
Sì. Genera dialogo (con sincronizzazione labiale in oltre 7 lingue), effetti sonori e audio ambientale nello stesso passaggio del video. Non è necessario alcun passaggio di produzione audio separato. L’audio è attivo di default e può essere disattivato se ti serve solo la traccia visiva.
Quali sono le principali limitazioni di Seedance 2.0?
Barriere di accesso regionale (principalmente legate alle piattaforme cinesi), moderazione dei contenuti aggressiva, API in fase beta, nessun supporto LoRA o fine-tuning, rendering del testo inaffidabile all’interno del video, termini di licenza commerciale poco chiari, una curva di apprendimento ripida e una lunghezza massima del clip di 15 secondi. Per i creator di contenuti sui social media in particolare: il limite di 15 secondi funziona per Reels, TikTok e Shorts, ma la curva di apprendimento e le segnalazioni di moderazione possono rallentare i flussi di lavoro ad alto volume dove la velocità conta più della precisione per clip.
Vale la pena passare a Seedance 2.0 per gli animatori professionisti?
Per gli animatori 2D/3D che necessitano di una generazione guidata da riferimenti — sì. Il sistema di riferimenti @ rispecchia il modo in cui gli animatori già lavorano: fogli di pose, turnaround e fotogrammi di stile diventano input diretti invece di cose da descrivere a parole. Il tasso di output utilizzabile del 90%+ al primo tentativo riduce significativamente i cicli di iterazione. Tuttavia, se il tuo flusso di lavoro dipende dal fine-tuning LoRA per modelli di personaggi personalizzati, Seedance 2.0 non lo supporta. Per lavori specifici sull’anime, anche Hailuo AI e PixVerse V6 producono risultati solidi a un costo per clip inferiore. La decisione si riduce a se il controllo dell’input multi-riferimento giustifichi il costo in crediti più elevato per la tua pipeline specifica.
Posso usare l’API di Seedance 2.0 nei flussi di lavoro di produzione?
L’API è in beta pubblica da aprile 2026. Supporta endpoint text-to-video e image-to-video con controllo parametrico di base. Tuttavia, i limiti di velocità, i cambiamenti dirompenti tra le versioni e la documentazione incompleta la rendono inadatta per ora a pipeline automatizzate critiche per la produzione. Per la generazione video programmatica oggi, l’API e la CLI di PixVerse offrono un accesso stabile a Seedance 2.0 insieme ad altri modelli — con endpoint coerenti, limiti di velocità documentati e integrazione Claude Code / Cursor per i flussi di lavoro di sviluppo.
Verdetto finale
Seedance 2.0 rappresenta un vero passo avanti per la generazione video IA — in particolare per i creator disposti a investire tempo nell’apprendimento del suo sistema di prompt multimodale. Il flusso di lavoro basato sui riferimenti, l’audio nativo e la generazione multi-scena basata su timeline lo avvicinano di più a uno strumento di produzione che a un generatore di novità.
Chi dovrebbe usare Seedance 2.0:
- Registi e animatori professionisti: Il migliore della categoria per narrazioni multi-riferimento e multi-scena. La curva di apprendimento ripaga se pensi già in termini di elenchi di scene e tavole di riferimento.
- Creator di contenuti sui social media: Praticabile per contenuti hero di alta qualità e video di campagna. Eccessivo per il volume di pubblicazione quotidiano — considera PixVerse V6 o Hailuo AI per flussi di lavoro orientati alla velocità.
- Aziende e team dipendenti dall’API: Aspetta che l’API esca dalla beta, oppure usa il livello API di PixVerse per un accesso programmatico stabile a Seedance 2.0 fin da oggi.
- Utenti occasionali e principianti: Inizia con PixVerse V6 o Hailuo AI — sistemi di prompt più semplici, risultati più veloci, costo per clip inferiore.
Non è per tutti. Se vuoi un prompt di una sola riga per produrre rapidamente un clip, modelli come Hailuo AI o PixVerse V6 ti porteranno lì più velocemente e con meno attrito. Se hai bisogno di output 4K, Veo 3 o Kling 3.0 sono scelte migliori. E se il controllo della camera è la tua priorità, PixVerse V6 offre attualmente opzioni più precise e parametrizzate rispetto all’approccio basato su prompt di Seedance 2.0.
L’argomento più forte per provare Seedance 2.0 adesso è che non devi scegliere un solo modello. Su PixVerse, puoi far passare lo stesso concept attraverso Seedance 2.0, V6, Kling e Veo, per poi confrontarlo con ogni modello di punta nella nostra rassegna dei generatori video IA — confronta i risultati e usa quello che funziona meglio per ogni scena. Questa flessibilità conta più del punteggio benchmark di un singolo modello.